DATA ENGINEERING · ETL · ANALYSE · BI
ORBITPME DATA CORE
Des données dispersées à des décisions métier fiables.
Ventes, stocks et finance réunis dans une vue contrôlée. Orbit démontre une chaîne complète d’ingénierie des données et vous permet d’explorer ses données métier synthétiques ici même.
01 / LE PROBLÈME
Une entreprise. Trop de versions de la réalité.
Les PME utilisent souvent des systèmes de vente, de stock, de CRM et de finance déconnectés. Le reporting devient incohérent, chronophage et difficile à vérifier.
Orbit consolide les exports, les transforme en modèles analytiques et vérifie leur cohérence avant de présenter les indicateurs métier.
Une vue commune des ventes et des marges, des ruptures de stock identifiées et une liste exploitable de factures à relancer.
02 / INTERACTIVE DEMO
Vos questions. Les vraies données de démo.
Changez de région, de canal ou de période. Ventes, clients et factures associées se mettent à jour ensemble. Chaque chiffre provient des fixtures synthétiques et des définitions métier du projet.
Cette démo côté navigateur n’exécute ni PostgreSQL, ni dbt, ni Dagster. La chaîne complète est reproductible localement depuis GitHub. Les stocks et la qualité concernent le jeu complet, pas une région ou une période de vente. Consulter les fixtures ↗
03 / DÉMONSTRATION
La chaîne complète en action.
Parcours de 78 secondes : contexte métier, architecture d’ingestion, véritable exécution Dagster, résultats de tests documentés et interface d’analyse Streamlit. Données entièrement synthétiques. Textes à l’écran en anglais ; aucune narration nécessaire.
04 / ARCHITECTURE
Des exports aux décisions.
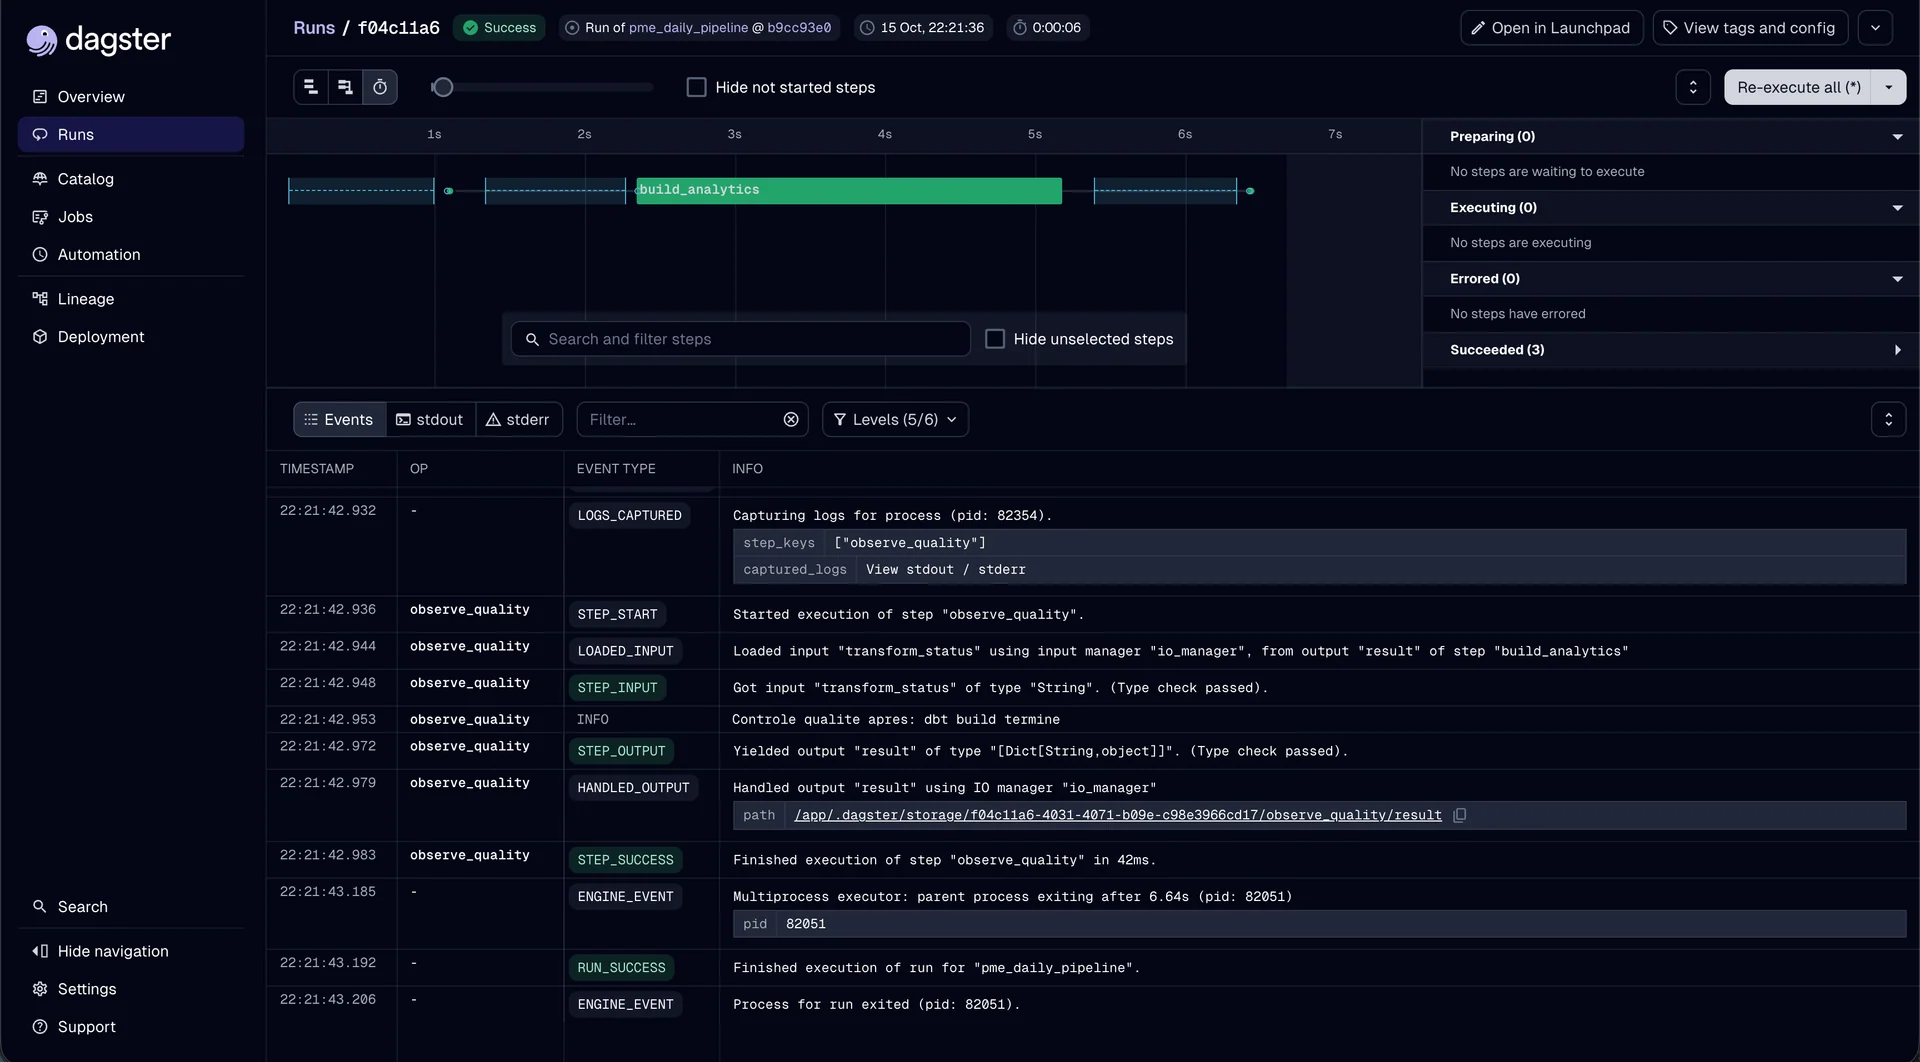
Sélectionnez une étape pour comprendre son rôle. Dagster orchestre l’ingestion, les transformations et les validations métier.
Orchestre le traitement et la validation
01CRM / ERP / FinanceCinq exports CSV synthétiques+
Des exports clients, commandes, lignes, stocks et factures représentent des systèmes opérationnels distincts.
02PythonIngestion incrémentale+
Contrats de colonnes, watermarks updated_at stricts et upserts idempotents chargent les lignes sources nouvelles ou modifiées.
03PostgreSQLStockage central+
Les schémas raw, metadata, staging, marts et observability séparent les sources, les transformations et les contrôles.
04SQL / dbtStaging et modèles métier+
Cinq vues de staging et cinq modèles métier rendent cohérentes les définitions des ventes, stocks et créances.
05ValidationIndicateurs contrôlés+
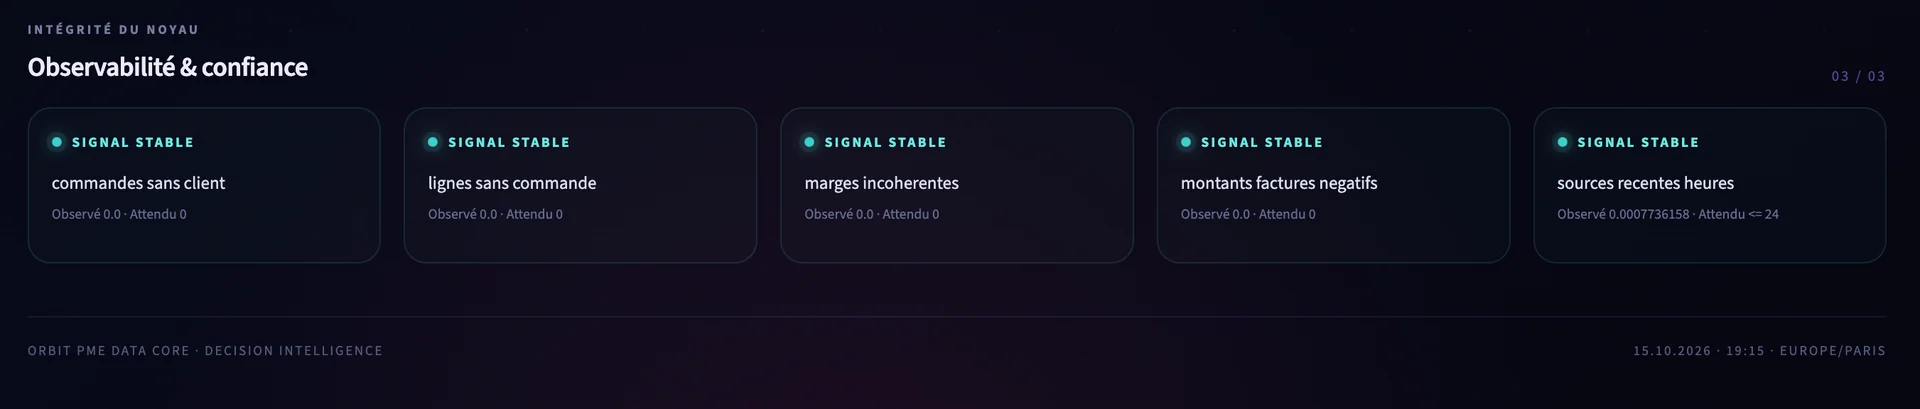
Les tests dbt vérifient clés et relations. Cinq contrôles métier vérifient intégrité, montants, marges et fraîcheur d’ingestion.
06Streamlit / PlotlyAnalyse métier+
Le dashboard local lit les modèles analytiques : ventes, marges, alertes de stock, impayés et résultats de qualité.
05 / VÉRIFICATION
L’ingénierie, preuves à l’appui.
Vérification locale documentée : 17 octobre 2026. Il s’agit de contrôles d’ingénierie, pas de résultats clients ni de benchmarks.
- Tests Python
- 4 / 4
- Modèles dbt construits
- 10
- Tests dbt
- 23 / 23
- Contrôles métier
- 5 / 5
- Lignes nouvelles au rejeu inchangé
- 0
- CI GitHub Actions
- Réussie
06 / L’APPLICATION
L’application réelle.
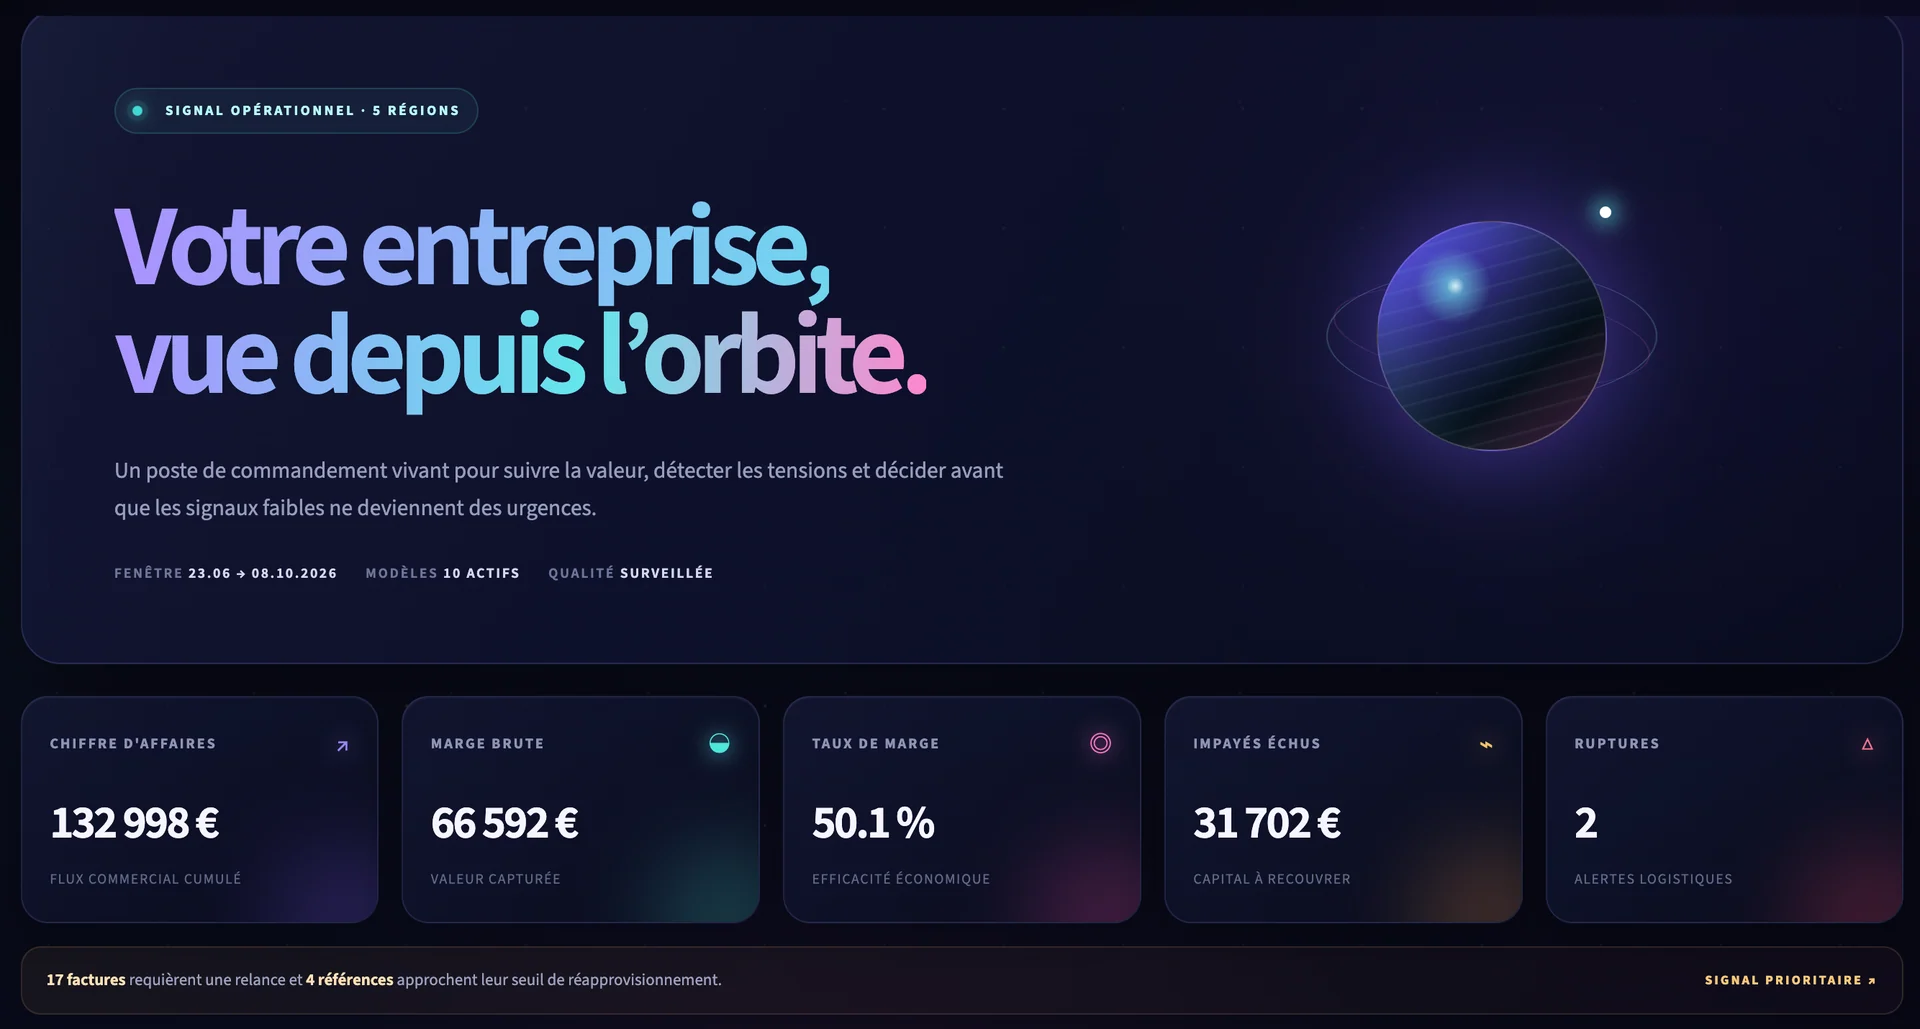
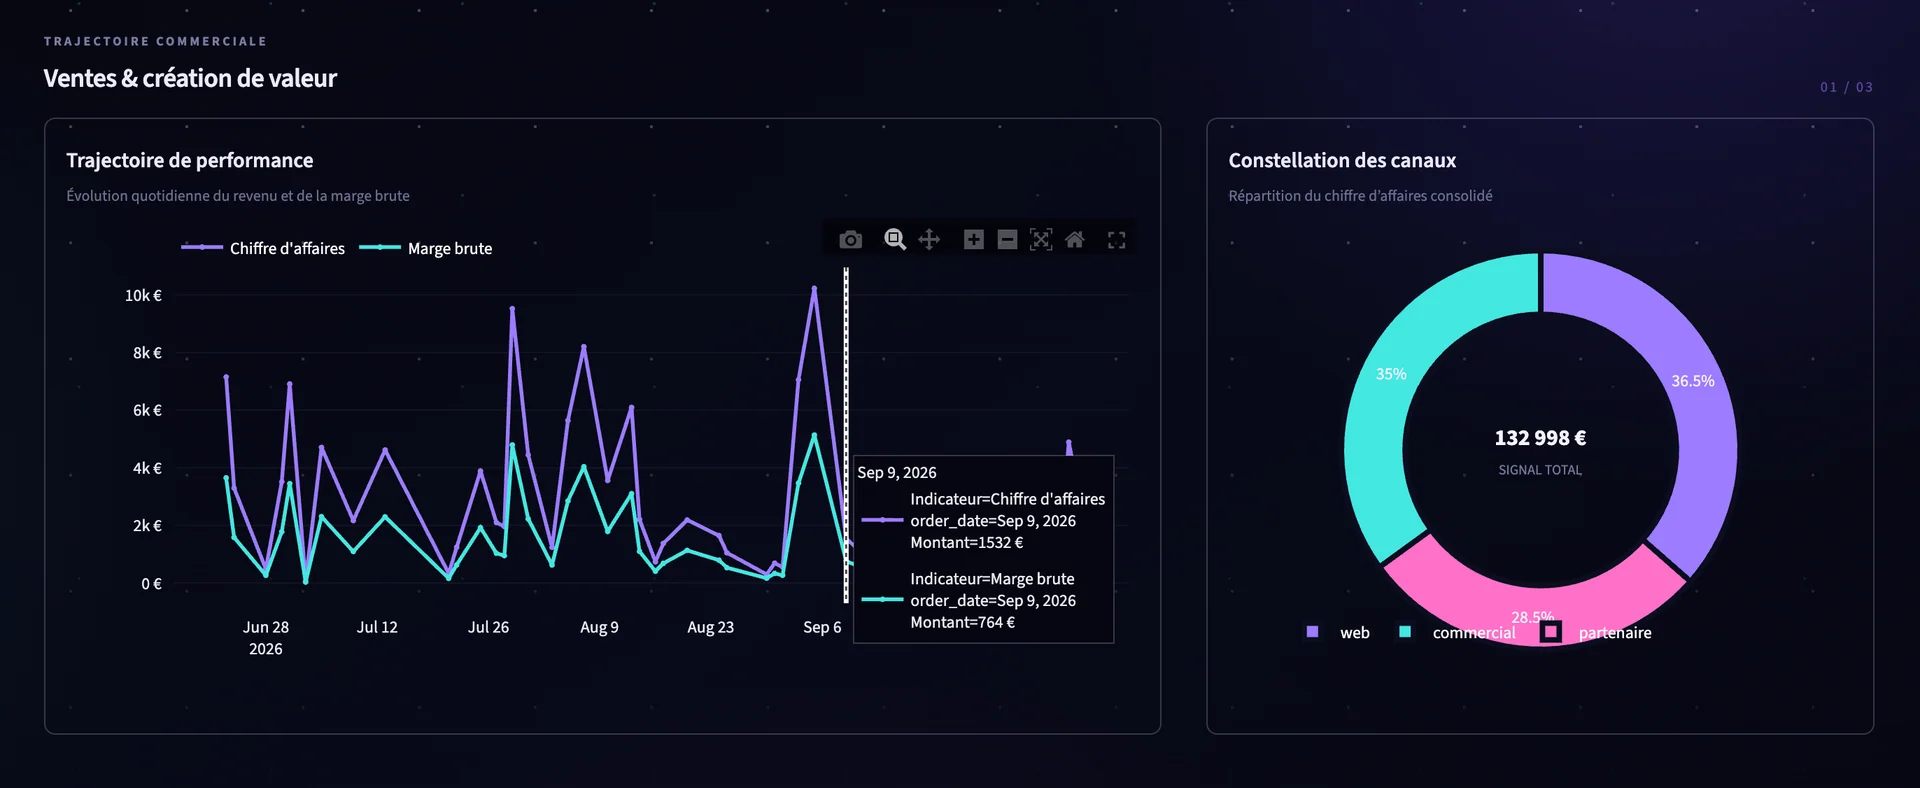
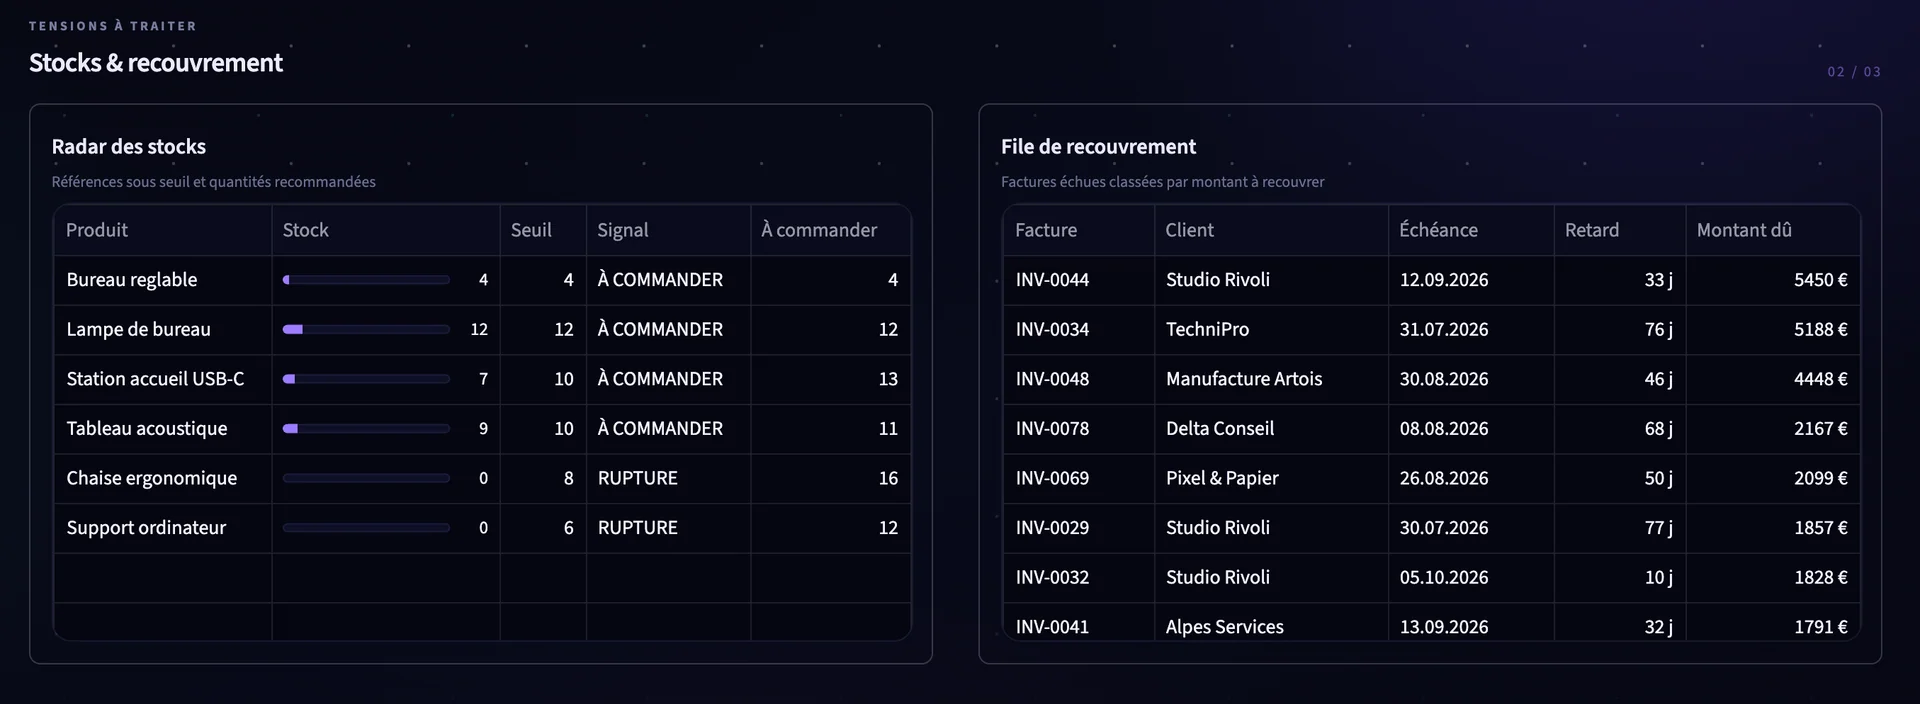
Captures originales du projet, optimisées pour le web. La vidéo et l’export des fixtures peuvent utiliser des dates de référence différentes.
07 / STACK
Des choix techniques explicites.
- Ingestion
- Python
- Base de données
- PostgreSQL
- Transformations
- SQL / dbt
- Orchestration
- Dagster
- Analyse
- Streamlit / Plotly
- Tests
- pytest / dbt tests / business validation
- Infrastructure
- Docker Compose / GitHub Actions
08 / VALEUR ET DÉCISIONS
Partir des questions métier.
- Consolider les sources de reporting
- Suivre ventes et marges brutes
- Repérer les ruptures de stock
- Prioriser les relances de factures
- Vérifier la cohérence des données
- Reproduire les processus de reporting
Fonctionnalités démontrées avec des exports synthétiques. Les connecteurs réels, KPI personnalisés et workflows propres à une entreprise sont des adaptations possibles qui nécessitent une implémentation et une validation distinctes.
Pourquoi PostgreSQL et dbt ?
PostgreSQL assure un stockage relationnel durable ; dbt explicite transformations, relations et tests dans du SQL versionné.
Pourquoi incrémental et idempotent ?
Les watermarks ignorent les lignes inchangées. Les upserts par clé permettent un rejeu sans doublons : le rejeu documenté n’a ingéré aucune nouvelle ligne.
Pourquoi une démo publique côté navigateur ?
Elle expose uniquement des données synthétiques et des calculs dérivés. Aucun accès public au propriétaire de la base, à Dagster, aux identifiants ou à l’écriture dans la chaîne locale.
Comment l’adapter à un client ?
Connecter les sources réelles, valider les définitions métier, puis ajouter droits minimaux, authentification, sauvegardes, supervision et exploitation. L’aptitude à la production exige une vérification distincte.
09 / À VOUS D’EXPLORER